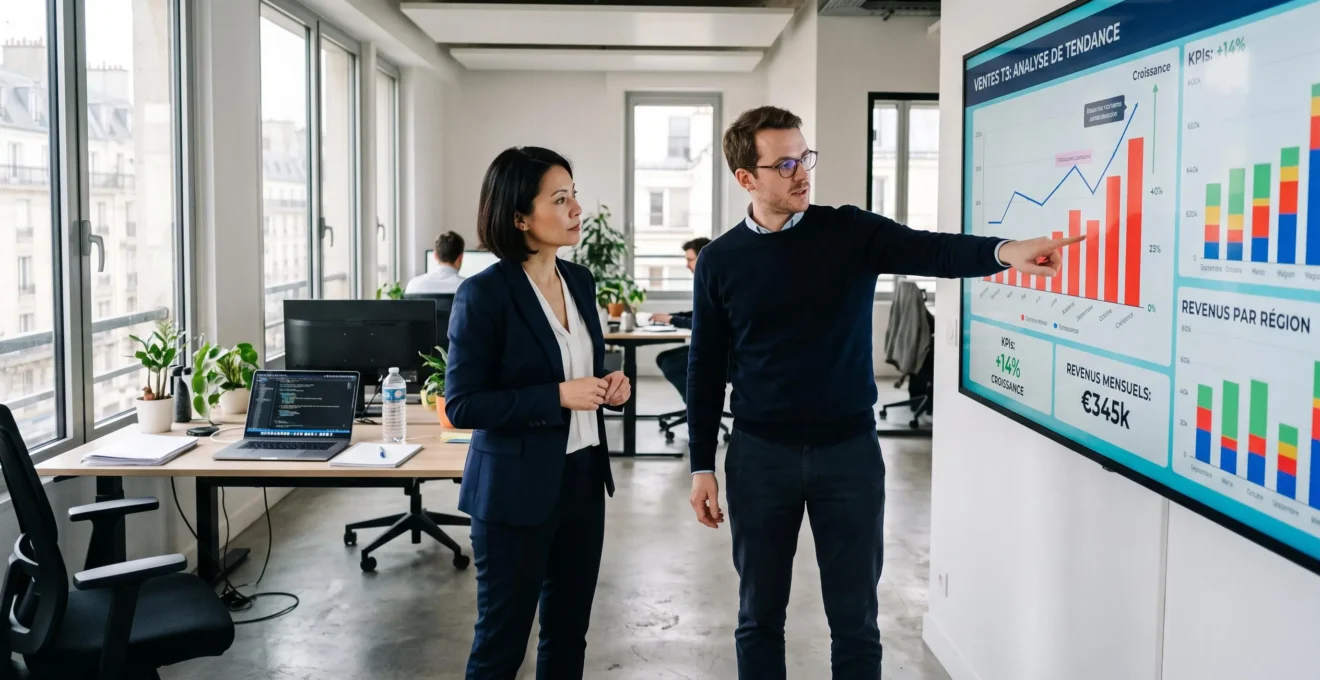
Les données s’accumulent dans les CRM, les ERP, les tableurs et les boîtes mail des équipes. Pour un dirigeant de PME ou d’ETI, la question n’est plus « faut-il faire de la data et de l’IA ? » mais « comment en tirer des décisions fiables, sans engager un budget disproportionné ni dépendre d’une technologie que l’on ne maîtrise pas ? ». La réponse tient en une séquence éprouvée : fiabiliser les données, poser une gouvernance, puis déployer des cas d’usage IA mesurables.
Réponse directe : Transformer ses données brutes en levier de décision suppose une démarche en étapes — audit des sources, mise en qualité, gouvernance conforme au RGPD, puis cas d’usage IA ciblés avec un indicateur de résultat défini au préalable. L’IA générative ou le machine learning ne produisent des gains tangibles qu’une fois ce socle en place.
Ce que recouvre une démarche data et IA utile
- Partir d’un audit lucide des sources et de la qualité des données.
- Installer une gouvernance et un cadre de conformité RGPD avant tout projet IA.
- Choisir des cas d’usage reliés à un indicateur métier précis.
- Industrialiser uniquement les expérimentations qui prouvent leur valeur.
Transformer des données brutes en levier de décision : par où commencer ?
Dans une PME, le constat se répète : les ventes sont suivies dans un CRM, la facturation dans un ERP, le pilotage commercial dans un tableur mis à jour chaque semaine. Trois sources, trois chiffres parfois incompatibles pour une même période. La décision se prend alors à l’intuition, faute de pouvoir trancher entre les indicateurs. C’est précisément ce symptôme qui révèle un besoin de structuration des données plutôt qu’un besoin d’intelligence artificielle.
Imaginons une ETI industrielle dont les ventes sont consolidées dans trois outils différents. Le directeur commercial annonce une croissance de 7 %, le contrôle de gestion mesure 4 %, et un reporting mensuel exporté à la main indique 9 %. Aucun des trois chiffres n’est faux : ils s’appuient simplement sur des périmètres, des dates de rattachement et des règles de calcul qui n’ont jamais été alignés. Lancer un projet d’IA prédictive sur cette base reviendrait à construire un modèle sur des fondations instables.
Le travail préalable consiste à passer de données brutes à une donnée fiabilisée : identifier les sources, cartographier leurs écarts, choisir un référentiel commun et définir qui est responsable de chaque indicateur. Cette étape est aussi le moment d’évaluer la maturité data de l’organisation. Un prestataire comme Deep intervient fréquemment à ce stade pour accompagner les PME et ETI françaises dans la structuration de leur socle data avant toute ambition IA.
Selon la Banque de France, l’écart d’adoption de l’IA en France par rapport à la zone euro s’explique en partie par des préoccupations liées aux données, à la vie privée et à l’éthique. Autrement dit, les entreprises françaises hésitent moins par manque d’intérêt que par manque de visibilité sur leurs propres données. Cette lecture change la priorité : avant d’investir dans un modèle, il faut savoir ce que l’on possède et ce que l’on peut en faire légalement.
Quelles sont les étapes clés d’une stratégie data et IA cohérente ?
Une stratégie data et IA opérationnelle se construit en quatre temps successifs : audit, gouvernance, architecture, industrialisation. Chaque étape conditionne la suivante et donne au dirigeant un point de décision clair pour continuer, ajuster ou arrêter l’investissement.
Audit de l’existant : cartographier et qualifier
L’audit consiste à inventorier les sources de données, à évaluer leur qualité (complétude, fraîcheur, unicité) et à mesurer leur accessibilité. Il permet aussi de hiérarchiser : toutes les données ne méritent pas le même effort de fiabilisation. L’objectif est d’identifier le périmètre minimum qui soutient les décisions à plus forte valeur — pilotage commercial, prévisions de stocks, suivi de la rentabilité par client.
Gouvernance et conformité RGPD : le socle de confiance
La gouvernance définit qui possède quelle donnée, qui peut y accéder, selon quelles règles. En France, ce cadre s’articule avec le Règlement général sur la protection des données. La CNIL met à disposition une boîte à outils (référentiels, guides pratiques, modèles) pour accompagner les organisations dans leur conformité. Les recommandations officielles de la CNIL couvrent également les spécificités de l’IA générative, ce qui concerne directement les projets envisagés par les PME.
Architecture et industrialisation
Le choix de l’architecture dépend de la taille de l’organisation et des volumes à traiter. Un pipeline type reste lisible : collecte depuis les sources métiers, nettoyage et transformation, stockage centralisé (data warehouse ou data lakehouse), puis exposition aux outils de visualisation et aux modèles d’IA. L’industrialisation marque le passage du pilote au déploiement en production, avec supervision, mises à jour et plan de reprise. C’est à cette étape que les coûts cachés — maintenance, suivi, dérive des modèles — doivent être anticipés.
Machine learning, IA générative et agents IA : quels usages pour vos processus métiers ?
Trois familles de technologies IA couvrent aujourd’hui l’essentiel des besoins d’une PME ou d’une ETI. Chacune répond à un type de problème différent, et chacune doit être évaluée avec un indicateur de résultat précis avant tout engagement.
Le machine learning prédit un comportement à partir de données historiques : prévision de la demande, détection d’anomalies, maintenance prédictive sur un parc machines. Son bénéfice métier se mesure en réduction de stock, en taux de disponibilité ou en marge opérationnelle. L’IA générative produit du contenu structuré — texte, résumé, extraction d’informations — et s’applique aux tâches documentaires : rédaction d’offres commerciales, synthèse de rapports, support aux équipes relation client. Son bénéfice se mesure en temps gagné par collaborateur et en volume traité. Les agents IA orchestrent plusieurs étapes successives — collecte, analyse, action — pour exécuter un workflow complet, comme le tri automatique des demandes entrantes vers le bon service.
- Diagnostic express de la maturité dataCartographier les sources principales, mesurer la qualité des données sur un périmètre réduit et identifier deux ou trois décisions métiers qui souffrent d’un manque de fiabilité. Durée indicative : quatre à six semaines.
- Sélection d’un cas d’usage à fort potentielChoisir un cas d’usage dont le gain est mesurable, le périmètre contenu et les données déjà accessibles. Préférer un chantier à retour visible en trois mois plutôt qu’un projet transformationnel sans échéance claire.
- Expérimentation encadrée puis industrialisationLancer un pilote avec un indicateur de résultat défini au départ. N’industrialiser que si la valeur est confirmée, en intégrant dès cette étape la supervision, la maintenance et la mise à jour des modèles.
Point de vigilance budgétaire : le coût d’un projet data et IA se concentre moins sur le développement initial que sur la maintenance et l’évolution dans la durée. Prévoir dès le cadrage une enveloppe récurrente pour la supervision des pipelines et des modèles évite les mauvaises surprises après la mise en production.
Pour les organisations qui ne disposent pas d’expertise interne, l’accompagnement par un partenaire couvrant l’ensemble du cycle — du cadrage à l’industrialisation — réduit la dépendance technique et sécurise les étapes clés. Le critère de choix prioritaire reste la capacité du partenaire à transférer la compétence au fil du projet, plutôt que d’installer une relation de dépendance durable.
La donnée n’est qu’un des piliers du pilotage de l’entreprise. Pour approfondir la place des outils relationnels dans ce dispositif, consulter cette analyse sur la stratégie d’entreprise autour du CRM.
Comment évaluer la maturité data de son organisation ?
L’évaluation repose sur trois dimensions : la qualité des données (complétude, cohérence, fraîcheur), la gouvernance (responsabilités, règles d’accès, conformité RGPD) et la capacité à exploiter (outils, compétences internes, culture de la décision chiffrée). Un diagnostic de quelques semaines, concentré sur deux ou trois processus métiers prioritaires, suffit à poser un niveau de départ réaliste.
Par où commencer un projet data et IA dans une PME sans expertise interne ?
Commencer par un cas d’usage concret, à périmètre réduit, dont le gain attendu peut s’exprimer en indicateur métier (temps gagné, marge, taux d’erreur). S’appuyer sur un partenaire capable d’intervenir sur toute la chaîne — audit, gouvernance, développement, industrialisation — et prévoir un transfert de compétence progressif vers les équipes internes.
Comment garantir la conformité RGPD dans un projet data et IA ?
La conformité se construit dès le cadrage : identification des données personnelles concernées, base légale du traitement, information des personnes, durée de conservation et sécurité des accès. Les référentiels et guides pratiques publiés par la CNIL couvrent les principaux cas, y compris les spécificités liées à l’IA générative. L’implication du délégué à la protection des données dès les premières étapes évite les reprises coûteuses.
Comment passer d’expérimentations IA à des résultats mesurables ?
La transition suppose trois conditions : un indicateur de résultat défini avant le pilote, une donnée d’entrée fiabilisée et un plan d’industrialisation qui intègre la supervision des modèles dans la durée. Un pilote qui ne prévoit pas sa mise en production reste une démonstration technologique, pas un projet métier.
La transformation data et IA d’une entreprise ne se mesure pas au nombre de technologies déployées, mais à la qualité des décisions qu’elle rend possibles. Pour un dirigeant de PME ou d’ETI, la prochaine étape utile tient en un geste : commander un diagnostic de maturité ciblé sur deux ou trois processus métiers, puis arbitrer en connaissance de cause sur l’opportunité d’un premier cas d’usage. Cette séquence courte, peu engageante financièrement, remplace avantageusement l’investissement précipité dans une technologie dont l’impact n’aurait pas été démontré.